Angesichts der kürzlich geschlossenen Partnerschaft zwischen IMTF und Babel Street beleuchten wir in diesem Artikel die Bedeutung des präzisen Namensabgleichs für die aufsichtsrechtliche Compliance sowie die Herausforderungen beim Screening von Namen in verschiedenen Sprachen.
Kernaussagen:
- Wenn Namen zu den wichtigsten Datenpunkten für die aufsichtsrechtliche Compliance gehören, können verschiedene Schreibweisen sehr herausfordernd sein.
- Der Namensabgleich bei chinesischen Schriftsystemen und Bildzeichen ist aufgrund phonetischer Varianten, unterschiedlicher Namensfolgen, Abkürzungen und kultureller Besonderheiten besonders anspruchsvoll.
- Zusätzliche Komplexität entsteht, wenn verschiedene Sprachen dasselbe Schriftsystem verwenden. Chinesisch, Japanisch und Koreanisch verwenden Schriftzeichen der Han-Schrift, sodass die Sprache allein anhand der Schriftzeichen nicht immer bestimmt werden kann.
- Einfache Methoden des Namensabgleichs führen häufig zu ungenauen Ergebnissen. Fehlertoleranter Namensabgleich nutzt hingegen maschinelles Lernen und erkennt ähnliche Namen.
- Beim fehlertoleranten Namensabgleich kommen Algorithmen mit bestimmten Einschränkungen, vor allem bzgl. nicht-lateinischer Schriftsysteme, zum Einsatz.
- Der IMTF-Partner Babel Street hat einen hybriden zweistufigen Abgleich entwickelt, der die Schwächen eines Verfahrens durch die Stärken des anderen zugunsten höherer Präzision, besserer Trefferquoten und Genauigkeit ausgleicht.
- Siron®One verwendet die fortschrittliche Namensabgleichtechnologie von Babel Street, welche die Han-Schrift sowie 24 weitere Schriftsysteme abdeckt, wodurch Kunden komplexe Anwendungsfälle bewältigen, Finanzkriminalität wirksam vorbeugen und ihre globalen Compliance-Prozesse optimieren.
Die Überprüfung der Namen von Kunden und Unternehmen gehört zu den grundlegenden Schritten beim Onboarding sowie bei KYC- und AML/CFT-Prozessen für Finanzinstitute und Nichtfinanzunternehmen. Aufsichtsbehörden weltweit verpflichten Unternehmen dazu, Namen mit Sanktions- und Beobachtungslisten abzugleichen. Zudem sind Financial Intelligence Units auf verifizierte Namen angewiesen, um Finanzdelikte untersuchen zu können.
Auch wenn der Namensabgleich zum wesentlicher Bestandteil von Compliance-Prozessen gehört, ist dieser äußerst komplex. Qualität, Genauigkeit und Geschwindigkeit wirken sich unmittelbar auf Risiken, Arbeitsaufwand und Kosten zentraler Compliance-Funktionen aus, etwa auf KYC oder Geldwäscheprävention.
Anders als eindeutige numerische Identifikatoren, z.B. Sozialversicherungsnummern oder numerische und biometrische Identifikatoren wie Aadhaar-Nummern, sind Namen nicht eindeutig einer bestimmten Person oder Organisation zugeordnet und können auf vielfältige Weise geschrieben werden. Abweichungen können u.a. durch phonetische Schreibweisen, Spitznamen, Kurzformen, Rechtschreibfehler, Bindestriche, Titel, kulturelle Unterschiede, Übersetzungen, Transliterationen, Aliase, verkürzte Namen, semantische Ähnlichkeiten und unterschiedliche Konventionen bei der Namensabfolge in Datenbanken entstehen.
Wenn Namen den wichtigsten Datenpunkt darstellen, können diese Varianten erhebliche Schwierigkeiten bereiten. Für weltweit tätige Finanzinstitute ist ein präziser Namensabgleich in vielen Sprachen jedoch für die Beachtung von KYC- und AML-Vorschriften unverzichtbar. Dieser muss Namen in ihren ursprünglichen Schriftsystemen erkennen und alle möglichen Übersetzungen und Transliterationen in anderen Sprachen berücksichtigen.
Komplexität des Namensabgleichs bei chinesischen Schrift- und Bildzeichen
Der Namensabgleich bei chinesischen Schriftsystemen und Bildzeichen ist aufgrund der Komplexität der Zeichen, phonetischer Varianten, unterschiedlicher Namensabfolgen, Abkürzungen und kultureller Besonderheiten mit speziellen Herausforderungen verbunden. Im Chinesischen besitzt jedes Zeichen eine eigene Bedeutung und Aussprache, weshalb eine rein zeichenkettenbasierte Strukturierung nur bedingt geeignet ist.
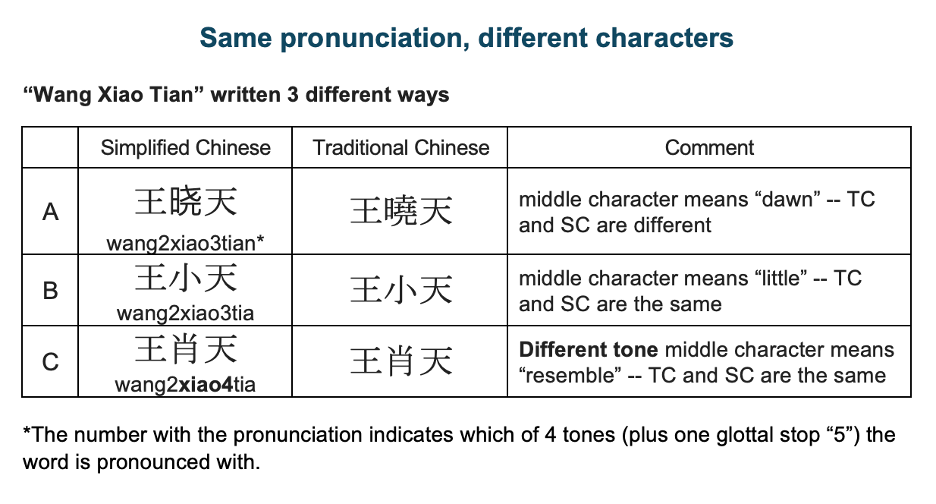
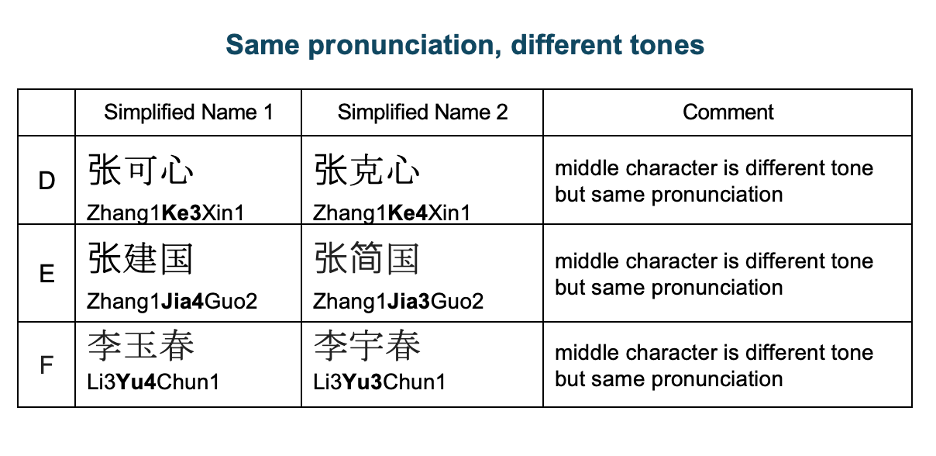
Chinesische Namen können in lateinischen Buchstaben auf unterschiedliche Weise wiedergegeben werden, etwa mithilfe des Pinyin-Systems. Dies kann zu erheblichen phonetischen Abweichungen führen. Zudem werden chinesische Namen traditionell mit dem Familiennamen an erster Stelle geschrieben, häufig abgekürzt und teils als Spitznamen oder in vereinfachten Schriftzeichen verwendet. Zudem können dieselben Zeichen je nach Kontext unterschiedliches bedeuten und verschieden ausgesprochen werden.
Zusätzlich komplex wird es, wenn verschiedene Sprachen dasselbe Schriftsystem verwenden. Chinesisch, Japanisch und Koreanisch verwenden die Han-Schrift. Die Unterscheidung ist daher besonders schwierig, wenn die Ausgangssprache unbekannt ist. Geschriebenes Koreanisch verwendet zwar hauptsächlich Hangul, enthält jedoch auch traditionelle chinesische Schriftzeichen. Diese werden im Koreanischen als Hanja, im Chinesischen als Hanzi und im Japanischen als Kanji bezeichnet und in jeder dieser Sprachen unterschiedlich dargestellt und ausgesprochen.1
Selbst innerhalb einer einzelnen Sprache kann die Transliteration von Namen variieren. Ein ausländischer Name wird im Japanischen beispielsweise häufig mit dem phonetischen Katakana und nicht mit Bildzeichen (Kanji) wiedergegeben.2
Diese Komplexität verdeutlicht den Bedarf an einer Namensabgleichmethode, die Han-Schriften versteht, die Ausgangssprache eines Namens erkennt und präzise Übersetzung und Transliteration gewährleistet.
Fehlertoleranter Namensabgleich
In verschiedenen Teilen der Welt werden Ausweisdokumente in der Landessprache ausgestellt, während Bankunterlagen auf Englisch geführt werden. Für den Abgleich mit einer Beobachtungsliste werden Namen daher häufig mit Schreibweisen in lateinischer Schrift verglichen. Eine simple lateinische Transliteration greift jedoch zu kurz, da Namen auf verschiedene Weise transliteriert werden können. In manchen Sprachen fehlen etwa bestimmte Laute, weshalb diese unterschiedlich wiedergegeben werden. So besistzt das Kantonesische keinen eigenständigen /r/-Laut. Bei der Wiedergabe eines fremdsprachigen /r/ kann daher u.a. anderem /l/ als nächstliegende lautliche Entsprechung verwendet werden.
Der Einsatz zu einfacher Methoden führt zu ungenauen Ergebnissen, erhöht die Zahl falsch-positiver sowie falsch-negativer Treffer und kann Reputationsrisiken verursachen, während manuelle Prüf- und Sortierprozesse die Compliance-Kosten erheblich in die Höhe treiben.
Der fehlertolerante Namensabgleich verwendet maschinelles Lernen zur Lösung dieser Probleme und gleicht Namen ab, die ähnlich sind. Das Verfahren berücksichtigt u.a. unterschiedliche Schreibweisen, Rechtschreibfehler und Formatierungsabweichungen. So kann es erkennen, dass sich „Jon“ und „John“ ggf. auf denselben Namen beziehen.
Beim fehlertoleranten Namensabgleich für chinesische Schriftsysteme und Bildzeichen müssen vor allem phonetische und strukturelle Ähnlichkeiten sowie der Kontext berücksichtigt werden.
Verfahren des fehlertoleranten Namensabgleichs und deren Nachteile
Für den fehlertoleranten Namensabgleich können verschiedene Algorithmen eingesetzt und an bestimmte Arten von Namensvarianten und Fehlern angepasst werden. Zu den verbreiteten Verfahren gehören:³
- Algorithmen zur Berechnung der Editierdistanz
Diese Verfahren messen, wie viele Bearbeitungsschritte erforderlich sind, um einen Namen in einen anderen umzuwandeln. Sie kommen unter anderem bei der Levenshtein-Distanz, Damerau-Levenshtein-Distanz, Jaro-Distanz, Jaro-Winkler-Distanz und Hamming-Distanz zum Einsatz.
Nachteil: Alle Änderungen und Vertauschungen werden identisch gewichtet, ohne kulturelle Besonderheiten zu berücksichtigen. Zudem ist dieses Verfahren weitgehend auf Namen in lateinischer Schrift beschränkt.
- Phonetischer Abgleich oder gemeinsamer Schlüssel
Dieses Verfahren konzentriert sich auf den Klang von Namen mit unterschiedlichen Schreibweisen, beispielsweise „Sara“ und „Sarah“. Zu den gängigen Verfahren gehören Soundex, Metaphone, Double Metaphone und NYSIIS (das New York State Identification and Intelligence System).
Nachteil: Diese Technik eignet sich vor allem für Namen in lateinischer Schrift. Bei nicht-lateinischen Schriftsystemen nimmt die Präzision erheblich ab.
- Listenmethode
Bei diesem Verfahren wird ein Name mit allen Varianten einer definierten Liste abgeglichen.
Nachteil: Der systematische Abgleich aller möglichen Kombinationen jedes Namensbestandteils mit allen denkbaren Varianten ist zeitaufwendig und ineffizient.
- Statistisches Verfahren oder Zeichenkettenvergleich
Diese Verfahren bewerten die Ähnlichkeit von Namen mittels statistischer Kennzahlen, etwa anhand der Häufigkeit bestimmter Zeichen oder Muster. Zu diesen gehören Kosinusähnlichkeit und Jaccard-Ähnlichkeit, der Dice-Koeffizient oder der Sørensen-Dice-Index sowie TF-IDF (Term Frequency–Inverse Document Frequency).
Nachteil: Obwohl diese Methoden sprachübergreifend präzise Ergebnisse liefern können, erfordern sie Training und Anpassungen. Hierdurch eignen sie sich weniger für Anwendungen, die besonders schnelle und dynamische Ergebnisse benötigen.
- Verfahren zur Einbettung von Wörtern
Bei dieser Methode werden Namen, Wörter oder Wortgruppen als Vektoren dargestellt. Ähnliche Wörter liegen im Vektorraum näher beieinander. Dabei werden kontextbezogene und semantische Varianten sowie Beziehungen zwischen Wörtern berücksichtigt.
Nachteil: Das Verfahren eignet sich besser für den Abgleich von Unternehmens- als für Personennamen.
Ferner existieren weitere Verfahren des fehlertoleranten Namensabgleich, etwa token-basierte Algorithmen, Deep-Learning-Modelle mit neuronalen Netzen und domänenspezifische Algorithmen, die besondere Abkürzungen und unterschiedliche Namenskonventionen berücksichtigen.
Hybride Methode mit zwei Durchläufen für höhere Präzision, Trefferquote und Genauigkeit beim fehlertoleranten Namensabgleich
Um die Grenzen einzelner Verfahren zu überwinden, setzt der IMTF-Partner Babel Street auf eine hybride Methode mit zwei Durchläufen. Dieser Ansatz kombiniert die Stärken mehrerer Techniken, um beim Namensabgleich eine höhere Präzision, Trefferquote und Genauigkeit zu erreichen.
Im ersten Durchlauf wird die Common-Key-Methode eingesetzt, um möglichst viele potenzielle Treffer zu erfassen. Dabei werden Namen bei Bedarf transliteriert und mögliche Übereinstimmungen eingegrenzt. Anschließend werden die Ergebnisse mittels statistischer Verfahren weiter verfeinert, um die Präzision zu erhöhen und die passendsten Treffer herauszufiltern.
Der Vorteil der statistischen Methode besteht darin, dass sie auf sprachspezifischen Varianten der Sprache basiert und nicht, wie die Listenmethode, auf der massenhaften Erzeugung möglicher Namensformen. Zudem kann sie Namen in unterschiedlichen Schriftsystemen miteinander vergleichen, was mit dem Editierdistanzverfahren nicht möglich ist.3
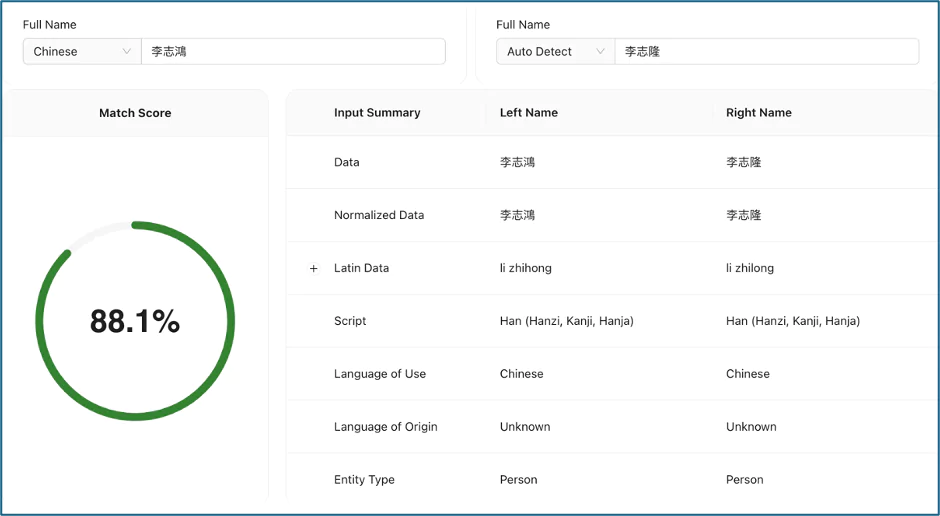
Im Kontext der Geldwäschebekämpfung oder Betrugsprävention muss das Namens-Screening, unabhängig von der eingesetzten Methode, schnell, präzise und zuverlässig sein. Es muss sich in das bisherige Abgleichsystem integrieren lassen, potenzielle Übereinstimmungen zügig eingrenzen und die Ergebnisse bewerten. Dabei erhalten die besten Treffer die höchsten Scores, wodurch sich der Aufwand für die manuelle Nachbearbeitung reduziert.4
Wie Siron®One und Babel Street beim Namensabgleich vorgehen
Ausgestattet mit der fortschrittlichen Technologie von Babel Street unterstützt Siron®One 24 Sprachen in verschiedenen Schriftsystemen, darunter auch Han-Schriften. Das System erkennt zuverlässig die Ausgangssprache von Namen und bewältigt komplexe Anwendungsfälle, etwa die Übertragung lateinischer Namen in japanische Entsprechungen mithilfe neuronaler Deep-Learning-Netze. 5
Diese Integration unterstreicht die Stärke der Zusammenarbeit zwischen IMTF und Babel Street und spiegelt das gemeinsame Engagement für Innovation und kundenorientierte Lösungen wider.
Durch die präzise und effiziente Bewältigung komplexer Anforderungen beim Namensabgleich stellt IMTF Kunden nicht nur im asiatisch-pazifischen Raum modernste Werkzeuge zur Verfügung, um neuen Anforderungen in den Bereichen Compliance und Betrugsprävention zu entsprechen.
In den kommenden Wochen wird IMTF Gil Irizarry, CIO bei Babel Street und Experte für fehlertoleranzen Namensabgleich interviewen. Bleiben Sie auf dem Laufenden und erfahren Sie mehr über die Herausforderungen für chinesische und andere nicht-lateinische Schriftsysteme und vor allem über deren Lösung.
Sprechen Sie mit uns, wenn Sie mehr wissen oder unsere Lösungen in Aktion sehen wollen.
Sources:
- https://www.babelstreet.com/blog/fundamentals-of-understanding-translating-and-matching-chinese-japanese-and-korean-names
- https://www.babelstreet.com/blog/why-japanese-transliteration-of-foreign-names-is-complex
- https://www.babelstreet.com/blog/fuzzy-name-matching-techniques
- https://www.babelstreet.com/blog/pairwise-name-matching-reduces-manual-compliance-remediation
- https://www.babelstreet.com/blog/deep-learning-brings-fuzzy-english-to-japanese-name-matching-into-focus